
Rehber
RAG (Retrieval-Augmented Generation) nedir ve kurumsal veriyle nasıl çalışır?
RAG, büyük dil modellerinin kurumsal/özel veriyle güncel ve doğrulanabilir cevaplar üretmesini sağlayan mimari yaklaşım. Nasıl çalıştığı ve ne zaman gerekli olduğu.
Büyük dil modelleri (LLM), eğitildikleri veri setinin ötesinde bir bilgiye doğrudan erişemez — bir şirketin iç dokümantasyonunu, güncel fiyat listesini veya son güncellenen destek makalelerini bilemez. Retrieval-Augmented Generation (RAG), bu sınırı aşmak için modelin cevap üretmeden önce ilgili belgeleri gerçek zamanlı olarak aramasını ve bu belgeleri bağlam olarak kullanmasını sağlayan bir mimari yaklaşımdır.
RAG nasıl çalışır?
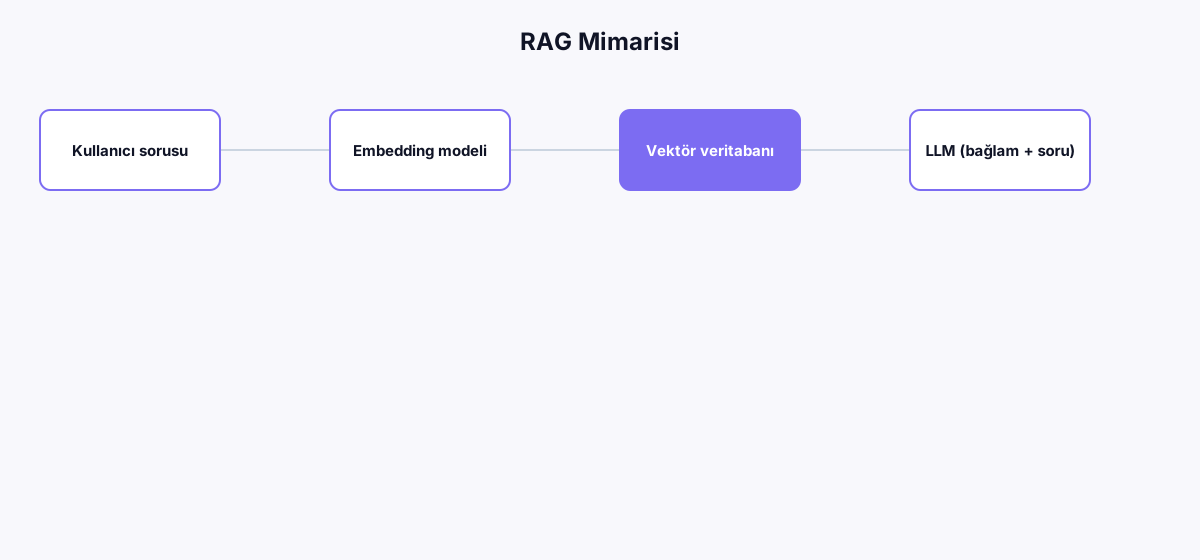
Temel akış dört adımdan oluşur: kullanıcı bir soru sorar; bu soru bir embedding modeliyle vektöre dönüştürülür; bu vektör, önceden indekslenmiş belge parçalarını içeren bir vektör veritabanında (anlamsal) benzerlik araması yapar; bulunan en alakalı belge parçaları, orijinal soruyla birlikte LLM'e bağlam olarak verilir ve model bu bağlama dayanarak cevap üretir.
Neden doğrudan fine-tuning değil?
| Kriter | RAG | Fine-tuning |
|---|---|---|
| Veri güncelliği | Kaynak belge güncellenince anında yansır | Modelin yeniden eğitilmesi gerekir |
| Maliyet | Vektör veritabanı + arama altyapısı | Eğitim/hesaplama maliyeti daha yüksek |
| Kaynak gösterme | Hangi belgeden alındığı izlenebilir | Modelin 'nereden bildiği' izlenemez |
| Model davranışı/üslup değişimi | Sınırlı — modelin temel davranışını değiştirmez | Model üslubunu/formatını kalıcı değiştirebilir |
Bu iki yaklaşım birbirini dışlamaz — bazı üretim sistemleri, modelin belirli bir formatta/üslupta cevap vermesi için hafif bir fine-tuning uygularken, güncel/özel bilgi için RAG kullanır.
Kurumsal bir RAG sisteminin bileşenleri
- Belge kaynağı (iç dokümantasyon, destek makaleleri, ürün kataloğu, PDF'ler)
- Parçalama (chunking) stratejisi — belgelerin ne boyutta parçalara bölüneceği
- Embedding modeli — metni vektöre dönüştüren model
- Vektör veritabanı — benzerlik araması yapılan depolama katmanı
- LLM — bağlamı alıp nihai cevabı üreten model
- Değerlendirme/izleme katmanı — cevapların doğruluğunun sürekli kontrolü
RAG'in sınırları
RAG, halüsinasyonu tamamen ortadan kaldırmaz — model, alınan belgeleri yanlış yorumlayabilir veya belgede olmayan bir bilgiyi 'tamamlayabilir'. Parçalama stratejisi kötü kurgulanmışsa (örneğin bir tablo ortadan bölünmüşse) arama kalitesi de düşer. Bu nedenle RAG sistemleri, cevapların kaynak belgeyle tutarlılığını doğrulayan bir değerlendirme sürecine ihtiyaç duyar.
Ne zaman RAG gerekli?
- Sık güncellenen, büyük hacimli bir bilgi tabanınız varsa (destek dokümantasyonu, ürün kataloğu)
- Cevapların hangi kaynağa dayandığının izlenebilir olması gerekiyorsa (uyumluluk/denetim ihtiyacı)
- Modelin şirkete özel, herkese açık olmayan veriyle çalışması gerekiyorsa
Sonraki adım
RAG'i üretime almadan önce küçük bir veri kümesiyle pilot bir uygulama kurup, arama kalitesini ve cevap doğruluğunu ölçmek; büyük ölçekte yatırım yapmadan önce mimarideki zayıf noktaları (parçalama, embedding kalitesi) erken tespit etmenin en güvenilir yoludur.
Kategoriler
Etiketler
Kaynaklar
Paylaş
İlgili içerikler
Yapay Zekâ Entegrasyonunda Kullanıcı Verisi Gizliliği Nasıl Korunur?
Web uygulamanıza yapay zekâ özelliği eklerken kullanıcı verilerinin gizliliğini korumak için nelere dikkat etmeniz gerektiğini anlatıyoruz.
2 dk okuma
Yazıyı oku
Web Projeleri İçin Doğru Yapay Zekâ Modeli Nasıl Seçilir?
Bir uygulamaya yapay zekâ özelliği eklerken hız, maliyet, doğruluk ve gizlilik arasındaki dengeyi gözeterek doğru modeli seçmenin kriterlerini anlatıyoruz.
2 dk okuma
Yazıyı oku
Yapay Zekâ Kod Tamamlama Araçları: Geliştiriciler İçin Karşılaştırma
GitHub Copilot, Claude Code ve benzeri yapay zekâ destekli kodlama asistanları geliştirici iş akışını nasıl değiştiriyor? Güçlü ve zayıf yönlerini karşılaştırıyoruz.
2 dk okuma
Yazıyı oku